SynthID: Wie KI-Texte ihr unsichtbares Wasserzeichen bekommen
SynthID ist ein von Google DeepMind entwickeltes Verfahren, das KI-Texte beim Schreiben unmerklich statistisch markiert. Es beeinflusst die Wortwahl nach einem geheimen Schlüssel, sodass ein Detektor das Muster später nachweisen kann, ohne dass Leser etwas bemerken.
Stell dir vor: Du schreibst einen Text komplett selbst. Dann bittest du eine KI, ihn "ein bisschen professioneller" zu machen. Und plötzlich behauptet ein Prüfwerkzeug, das Ganze sei durch KI entstanden. Willkommen im Zeitalter der unsichtbaren Wasserzeichen. Aber zum Glück ist es nicht ganz so schlimm, wie wir sehen werden.
Hinter dem Schlagwort KI Wasserzeichen steckt ein eleganter Trick, den Google DeepMind unter dem Namen SynthID entwickelt hat. Er markiert KI-Texte nicht mit einem Stempel oder Dateivermerk, sondern mit Mathematik in der Wortwahl selbst.
In diesem Beitrag gehen wir Schritt für Schritt vor, auch ohne Informatikstudium:
- Erst die einfache Variante: statische Wasserzeichen, die man mit bloßem Auge versteht.
- Dann die Praxis: Überlebt SynthID Korrekturen, neue Chats und Übersetzungen?
- Danach der Blick unter die Haube: das Turnier-Verfahren (Tournament Sampling).
- Zum Schluss die Folgen für Autoren, Hochschulen und Plagiatsprüfung sowie eine Checkliste für KMU.
Inhalt dieses Beitrags
Table of Contents
- SynthID: Wie KI-Texte ihr unsichtbares Wasserzeichen bekommen
- Inhalt dieses Beitrags
- Was ist SynthID und warum gibt es KI-Wasserzeichen?
- Wasserzeichen für Anfänger: Drei einfache Beispiele (die man leicht knackt)
- SynthID Text in der Praxis: Was übersteht das Wasserzeichen und was nicht?
- Vorab in kurz später ausführlich: wie funktioniert SynthID?
- Ab welcher Textlänge ist SynthID aussagekräftig?
- Korrektur, Teil-Generierung und KI-Überarbeitung: Ab wann wird mein Text "KI"?
- Absatzweise generieren und neue Chats starten: Hilft das?
- Übersetzungen: Die Wasserzeichen-Waschmaschine?
- Mythos: "SynthID tauscht einfach Synonyme aus"
- Stärken und Schwächen auf einen Blick
- Wie zuverlässig sind KI-Detektoren wirklich?
- Unter der Haube: Tournament Sampling einfach erklärt
- Die Folgen: Wer ist der Autor, wenn der Detektor nur die Form prüft?
- Gedanke vs. Ausschreiben: Der zweite Schritt wird dominant
- Der Zwang zum Selberschreiben: Wenn Effizienz zum Risiko wird
- Der Blender und der effiziente Denker: Das Detektor-Paradoxon
- Generativer vs. kuratierender Autor
- Hochschule und Plagiatsprüfung: Was ein Wasserzeichen vor der Prüfungskommission wert ist
- Detektoren, Schlüssel und Trainingsdaten: Wer darf prüfen?
- Ausblick: Vom Textnachweis zum Denknachweis
- Was heißt das für Privatpersonen und KMU? (Praxis-Checkliste)
- Fazit: Wasserzeichen sind ein Indiz, kein Beweis
- FAQ
- Was ist SynthID?
- Wie viele Wörter braucht SynthID Text für eine Erkennung?
- Übersteht SynthID Rechtschreibkorrekturen?
- Funktioniert SynthID nach einer Übersetzung noch?
- Kann ich SynthID selbst nutzen?
- Ist ein KI-Text mit Wasserzeichen automatisch schlecht oder verboten?
- Kann eine Hochschule mit einem Detektor beweisen, dass ich KI genutzt habe?
Was ist SynthID und warum gibt es KI-Wasserzeichen?
SynthID ist eine Wasserzeichen-Technologie von Google DeepMind für KI-generierte Texte, Bilder, Videos und Audio. Die Markierung steckt im Inhalt selbst und nicht in den Metadaten, bleibt daher auch nach moderaten Veränderungen oft erhalten. Die LLM Anbieter brauchen das um ihre neuen Modelle nicht mit selbst generierten Texten ihrer alten Modelle zu trainieren.
KI-Inhalte sind inzwischen so gut, dass Menschen sie kaum noch von echten unterscheiden können. Das ist praktisch, aber auch ein Problem: für Vertrauen, für Desinformation und, ganz unromantisch, für die KI-Firmen selbst, die ihre nächsten Modelle nicht mit den Texten der vorherigen füttern wollen - Stichwort "Model Collapse".
Die Idee der Wasserzeichen: Wer KI-Inhalte erzeugt, hinterlässt dabei ein Muster, das Menschen nicht auffällt, ein Prüfprogramm aber findet.
Wasserzeichen im Inhalt statt in den Metadaten
Metadaten-Kennzeichnungen sind Zusatzinformationen in einer Datei und lassen sich leicht löschen. Ein Wasserzeichen im Inhalt selbst ist deutlich robuster, weil es Teil des Textes, Bildes oder Tons ist.
Der klassische Weg ist ein Vermerk in den Dateiinformationen, etwa nach dem Standard C2PA (Content Credentials). Der hat nur einen Haken: Ein Screenshot, ein Copy-and-paste oder ein Klick auf "Metadaten entfernen" genügt, und der Vermerk ist weg. Er ist wie ein Post-it am Foto: nützlich, aber schnell abgezogen.
SynthID geht deshalb den anderen Weg und verändert den Inhalt selbst, so minimal, dass wir es nicht sehen, ein Detektor aber schon.
SynthID bei Bildern, Videos und Audio (kurzer Überblick)
Bei Bildern und Videos verändert SynthID Pixelwerte so geringfügig, dass das Auge nichts bemerkt. Bei Audio wird das Muster im Spektrogramm, einer Frequenzdarstellung des Tons, eingebettet.
Auch wenn dieser Beitrag vom Text handelt, hier die Kurzfassung für die anderen Medien:
- Bilder und Videos: Ein Deep-Learning-Modell verändert die Farbwerte einzelner Pixel minimal. Das Muster ist über das ganze Bild verteilt und übersteht oft Zuschneiden, Komprimieren oder Filter.
- Audio: Die Schallwelle wird in ein Spektrogramm umgerechnet, das Muster wird dort eingearbeitet und das Ganze wieder zurück in Ton verwandelt. Auch Tempoänderungen und Kompression überstehen solche Zeichen häufig.
Text ist die Königsdisziplin des Unauffälligen, denn hier gibt es keine Pixel, nur Wörter. Dazu gleich mehr.
Wo wird SynthID eingesetzt, und was sagt der EU AI Act?
SynthID ist in Googles Modelle wie Gemini, Imagen und Veo integriert. Der EU AI Act verlangt in Artikel 50 seit dem 2. August 2026 eine Kennzeichnung KI-generierter Inhalte, nennt aber keine bestimmte Technik. Auch Anthropic nutzt ein ähnliches Verfahen.
Eingesetzt wird SynthID in den Google-eigenen Modellen. Für Entwickler hat Google die Textvariante zusätzlich als Open-Source-Bibliothek veröffentlicht, nachzulesen im Hugging-Face-Blog zu SynthID Text. Wichtig dabei: Das Verfahren ist offen, die Schlüssel der Anbieter sind es nicht. Dazu später mehr.
Zur Rechtslage (Stand Ende Oktober 2026, kein Rechtsrat):
- Artikel 50 des AI Act regelt Transparenzpflichten für KI-Inhalte und gilt seit dem 2. August 2026.
- Anbieter generativer KI müssen ihre Ausgaben maschinenlesbar markieren. Für Systeme, die schon vor August 2026 am Markt waren, hat der "Digital Omnibus" die Frist für diese technische Kennzeichnung auf den 2. Dezember 2026 geschoben.
- Der AI Act schreibt kein bestimmtes Verfahren vor. SynthID ist also eine mögliche Umsetzung, keine Pflicht.
- Für Betreiber, die KI-Texte veröffentlichen, gibt es eigene Regeln und Ausnahmen, zum Beispiel bei redaktioneller Prüfung oder rein privater Nutzung. Im Zweifel: Rechtsberatung.
Wasserzeichen für Anfänger: Drei einfache Beispiele (die man leicht knackt)
Ein statisches Wasserzeichen folgt einer festen, unveränderlichen Regel, etwa einer Lieblingsphrase oder einer Buchstabenhäufigkeit. Es ist leicht zu verstehen, aber ebenso leicht zu erraten und zu entfernen.
Bevor wir SynthID auseinandernehmen, lohnt sich ein Aufwärmen mit drei Wasserzeichen, die du sofort durchschaust. Sie funktionieren nach dem gleichen Grundprinzip wie das große Vorbild, nur eben deutlich plumper. Das macht sie zu guten Lehrbeispielen.
Beispiel 1: Die KI-Lieblingsphrase ("nicht nur ..., sondern auch")
Beim Lieblingsphrasen-Wasserzeichen verwendet die KI eine feste Wendung auffällig oft. Der Detektor sucht starr nach genau dieser Wortfolge.
Angenommen, eine KI soll in jedem Text über 100 Wörter mindestens zweimal diese Konstruktion nutzen:
Diese Technologie ist nicht nur extrem sicher, sondern auch zukunftsweisend.
Der Detektor muss nur nach der Wendung suchen. Das Problem liegt auf der Hand:
- Auch Menschen schreiben so, es gibt also Fehlalarme.
- Wer die Formulierung streicht, hat das Wasserzeichen gelöscht.
Übrigens: Dass manche KI-Texte solche Lieblingswendungen von selbst haben, ist kein Wasserzeichen, sondern eine Angewohnheit. Als Indiz taugt sie trotzdem, aber als Beweis eben nicht.
Beispiel 2: Das Buchstaben-Sieb (Verteilung des "e")
Beim Buchstaben-Sieb bevorzugt oder meidet die KI bestimmte Buchstaben, sodass die Häufigkeitsverteilung vom normalen Sprachgebrauch abweicht. Der Detektor zählt Buchstaben und erkennt die Abweichung.
Im Deutschen ist das "e" mit Abstand der häufigste Buchstabe. Nehmen wir an, die KI bekommt die Regel: "Bevorzuge Wörter mit weniger e."
- Normal (8 "e" bei 44 Zeichen):
Es ist heute ein sehr schöner Tag zum Spazierengehen. - Mit Wasserzeichen (5 "e" bei 56 Zeichen):
Das Wetter am heutigen Tag lädt zum absolut tollen Spaziergang ein.
Der Detektor zählt die Buchstaben. Liegt der e-Anteil plötzlich bei der Hälfte des Üblichen, schlägt er an. Schwäche: Solche Texte klingen schnell hölzern, das Muster kann jeder statistisch identifizieren und wer dann ein paar Wörter durch e-reiche Varianten ersetzt, bringt die Statistik wieder in Ordnung.
Beispiel 3: Das Akrostichon (versteckte Botschaft in Satzanfängen)
Beim Akrostichon ergeben die Anfangsbuchstaben aufeinanderfolgender Sätze ein geheimes Wort. Der Detektor liest nur die Satzanfänge und prüft, ob das Wort herauskommt.
Dieser Trick ist Jahrhunderte alt. Die Regel lautet hier: Die Satzanfänge ergeben "KI".
Künstliche Intelligenz verändert unsere Welt rasant.Immer mehr Menschen nutzen diese Werkzeuge täglich.
K, I: Volltreffer. Der Nachteil: Schiebt jemand einen Satz dazwischen oder tauscht die Reihenfolge, ist die Botschaft kaputt.
Warum statisch nicht reicht und dynamisch besser ist
Statische Wasserzeichen folgen immer derselben Regel und sind deshalb leicht zu erraten. Dynamische Wasserzeichen wie SynthID ändern ihre Regel bei jedem Wort in Abhängigkeit von einem geheimen Schlüssel.
Alle drei Beispiele haben denselben Konstruktionsfehler: Die Regel ist immer gleich. Wer sie kennt oder errät, kann sie mit minimalem Aufwand aushebeln.
SynthID macht im Prinzip dasselbe, nämlich eine statistische Abweichung in den Text einbauen, würfelt die Regel aber nach jedem Wort neu aus, und zwar nach einem Schlüssel, den nur der Betreiber kennt. Wie das genau geht, klären wir im Kapitel über das Turnier. Vorher schauen wir uns an, was das Wasserzeichen in der Praxis aushält.
SynthID Text in der Praxis: Was übersteht das Wasserzeichen und was nicht?
SynthID Text braucht je nach Quelle grob 50 bis 100 Wörter für einen Nachweis und wird ab etwa 300 Wörtern deutlich zuverlässiger. Rechtschreibkorrekturen übersteht es, starkes Paraphrasieren und Übersetzen zerstören es in der Regel.
Zeit für die Bestandsaufnahme. Vorab: Alle Zahlen in diesem Kapitel sind Faustregeln, keine Garantien. Die genauen Werte hängen von Modell, Einstellung und Text ab. Die wissenschaftliche Grundlage findest du im Nature-Paper zu SynthID Text.
Vorab in kurz später ausführlich: wie funktioniert SynthID?
Wenn ein LLM einen Text schreibt, generiert es immer das nächste wahrscheinlichste Token (ca. ein Wort) basierend auf dem Kontext und den letzten Wörtern.
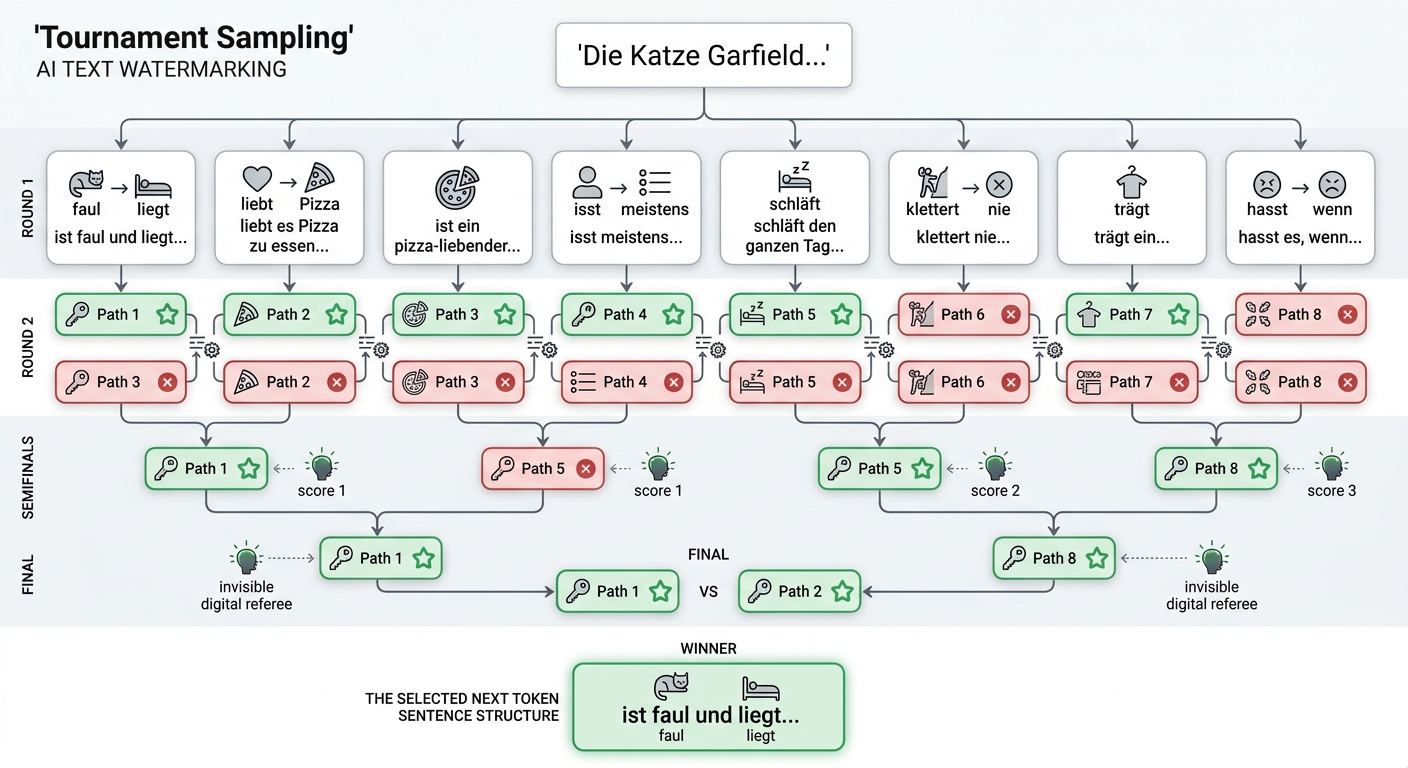
SynthID generiert nun nicht nur das eine wahrscheinlichste Wort, sondern mehrere, z.B. die wahrscheinlichsten 8. Unter diesen 8 wählt es dann gemäß des geheimen Schlüssels eins aus. Dies können Synonyme sein, wie "Couch" vs. "Sofa" aber auch der Satzbau kann sich ändern, wodurch völlig unterschiedlich Wörter zur Auswahl stehen.
Die Katze Garfield...
kann weitergeführt werden als
...liebt Pizza und ist sehr faul....flenzt faul auf dem Sofa und isst Pizza.
Das nächste Wort wäre also wahlweise liebtoder flenzt.
Welches davon genommen wird entscheidet eine Berechnung mit dem Schlüssel.
Ab welcher Textlänge ist SynthID aussagekräftig?
Als Faustregel braucht der Detektor mindestens 50 bis 100 Wörter für ein Signal und etwa 300 Wörter für hohe Zuverlässigkeit. Kurze, rein faktische Texte eignen sich kaum, weil dort wenig Spielraum für die Wortwahl besteht.
Das Wasserzeichen ist ein statistisches Muster, und Statistik braucht Masse. Ein einzelner Satz sagt nichts, erst viele winzige Abweichungen summieren sich zu einem eindeutigen Befund.
Schlecht markierbar sind außerdem Inhalte, bei denen es nur eine sinnvolle Formulierung gibt:
- Fakten wie
Die Hauptstadt von Frankreich ist Paris. - Programmcode und Formeln
- reine Datenlisten
Wo die KI nicht zwischen mehreren gleich guten Wörtern wählen kann, gibt es nichts zu markieren.
Korrektur, Teil-Generierung und KI-Überarbeitung: Ab wann wird mein Text "KI"?
Reine Tippfehler- und Grammatikkorrekturen erzeugen kein nennenswertes Wasserzeichen. Entscheidend ist, wie viele zusammenhängende Wörter die KI selbst neu formuliert, grob ab 60 bis 100 Wörtern am Stück.
Zwei Richtungen, zwei Antworten.
Richtung 1: Die KI hat geschrieben, du korrigierst. Kommas setzen, Tippfehler beheben, einzelne Wörter tauschen: Das betrifft nur einen kleinen Teil der Wortübergänge. Der Rest des Musters bleibt intakt, und der Detektor erkennt es weiterhin.
Richtung 2: Du hast geschrieben, die KI überarbeitet. Hier kommt es auf den Prompt an:
Korrigiere nur die Grammatik.Die KI ändert kaum Wörter, es entsteht kein relevantes Wasserzeichen.Formuliere diesen Text professioneller.Die KI wählt Wörter neu aus, und genau dabei kann das Muster eingebettet werden.
Und wenn nur ein Teil von der KI stammt? Schreibst du selbst und lässt die KI nur einen Absatz erzeugen oder umschreiben, steckt das Wasserzeichen genau in diesem Absatz. Ist er lang genug, kann der Detektor anschlagen, der Rest bleibt unauffällig.
Zwei Rechenbeispiele bei einem Text mit 500 Wörtern:
- Die KI ändert hier und da ein Wort und optimiert zwei Sätze (insgesamt etwa 30 Wörter). Der menschliche Ursprung dominiert, der Detektor bleibt in der Regel negativ.
- Die KI formuliert deinen holprigen Entwurf so um, dass etwa 70 % der Sätze mit neuen Worten dastehen. Das Signal reicht, der Detektor schlägt vermutlich an.
Die Faustregel: Der Kipppunkt liegt dort, wo die KI nicht mehr nur deine Struktur repariert, sondern die Wortwahl übernimmt. Sobald ein zusammenhängender Block von etwa 60 bis 100 Wörtern überwiegend aus der "Feder" der KI stammt, kann das Signal ausreichen.
Absatzweise generieren und neue Chats starten: Hilft das?
Nein. Das Wasserzeichen hängt nur von den unmittelbar vorangehenden Wörtern ab, nicht vom Chatverlauf. Auch absatzweise erzeugte Texte tragen daher ihr Muster, solange die Abschnitte lang genug sind.
Der Gedanke ist naheliegend: Jeder Absatz kommt aus einem frischen Chat, und schon findet der Detektor keinen roten Faden. Er scheitert aber an der Funktionsweise.
- Die Bewertung eines Wortes hängt nur von den Wörtern direkt davor ab (bei der Open-Source-Variante standardmäßig vier Tokens, also Wortteile). Ein Chatverlauf oder ein Prompt spielt dafür keine Rolle.
- Ein typischer Absatz hat 80 bis 150 Wörter und bringt damit schon genug statistische Masse mit.
- An der Klebestelle zwischen zwei Absätzen passt der Kontext für ein paar Wörter nicht, danach stimmt er wieder. Der Detektor wertet jedes Wort nur anhand seiner Vorgänger aus, er muss gar nicht wissen, wo du geklebt hast.
Theoretisch könnte es kippen, wenn du nur Fragmente von 10 bis 15 Wörtern einzeln erzeugen und zusammensetzen würdest. Das ist so mühsam, dass man den Text dann auch selbst schreiben könnte.
Übersetzungen: Die Wasserzeichen-Waschmaschine?
Eine Übersetzung zerstört ein vorhandenes Textwasserzeichen, weil sich alle Wortfolgen ändern. Ein neues Wasserzeichen lässt sich nur schwer einbetten, wenn die Übersetzung wenig Formulierungsfreiheit lässt.
Wasserzeichen im Text leben von Wortfolgen. Wer einen Text übersetzt, ändert Grammatik, Satzbau und jedes einzelne Wort. Das englische "Tournament" existiert im Deutschen schlicht nicht mehr, der Detektor sieht nur noch Rauschen.
Ob die Übersetzung selbst ein neues Zeichen trägt, hängt vom Spielraum ab:
- Fachtexte, Anleitungen, Gesetze: Es gibt oft nur eine passende Übersetzung. Ohne Wahlmöglichkeit kein Turnier, also kaum Wasserzeichen.
- Literarische Texte: Mehr Freiheit bei Satzstellung und Adjektiven, also mehr Chancen für ein schwaches bis mittleres Zeichen.
Wer einen Text hin und her übersetzt und fordert nah am Original zu übersetzen, wäscht das Zeichen heraus ohne, dass ein neues zuverlässig eingebaut werden kann. Ein Wasserzeichen ist deshalb ein Indiz, aber nie ein lückenloser Beweis.
Die Katze Garfield... flenzt faul auf dem Sofa und genießt Pizza.Garfield the cat... is lazing around on the sofa, enjoying some pizza.Die Katze Garfield... faulenzt auf dem Sofa und genießt ein Stück Pizza.
Die Wortketten sind aufgebrochen, aber die Kernwörter und Satzstruktur sind bei der Rückübersetzung vorgegeben, wodurch die Freiheit der Wortwahl eingeschränkt wird. Das alte Wasserzeichen wird stark geschwächt, ein neues kann nur schwach eingebaut werden.
Mythos: "SynthID tauscht einfach Synonyme aus"
SynthID tauscht keine Wörter nachträglich aus und fügt keine Füllwörter ein. Es lenkt schon beim Schreiben die Wahl zwischen gleichwertigen Formulierungen und erzeugt so ein statistisches Muster.
Ein verbreitetes Missverständnis lautet, die KI schreibe heimlich "Wagen" statt "Auto" oder schmuggle ein zusätzliches "und" ein. Das stimmt so nicht. Füllwörter würden den Text holprig machen, und häufige Wörter wie "und" oder "der" taugen statistisch ohnehin nicht als Erkennungszeichen.
Stattdessen nutzt SynthID die natürliche Vielfalt der Sprache. Fast an jeder Stelle gibt es mehrere gleich gute Fortsetzungen, zum Beispiel:
Das System ist effizient, weil ...Da das System effizient ist, ...
Welche der beiden Varianten gewinnt, entscheidet unauffällig der geheime Schlüssel. Ein nachträglicher Gang durchs Synonymwörterbuch ändert daran meist wenig, solange der Satzbau im Großen und Ganzen bleibt.
Stärken und Schwächen auf einen Blick
SynthID Text funktioniert gut bei langen, frei formulierten Texten und übersteht Korrekturen sowie Stückelung. Schlecht funktioniert es bei kurzen oder rein faktischen Texten, Übersetzungen und starkem Paraphrasieren.
Hier funktioniert es gut:
- Lange, zusammenhängende Texte (Aufsätze, Artikel, Berichte)
- Umfassende stilistische KI-Überarbeitungen oder ganzes Ausformulieren von Stichpunkten
- Bleibt erhalten bei formalen Anpassungen wie Rechtschreibung, Grammatik und Zeichensetzung
- Stückeln auf mehrere Prompts, Chats oder Absätze stört nicht
Hier funktioniert es weniger gut:
- Sehr kurze Texte (Social-Media-Posts, kurze E-Mails, Produktbeschreibungen)
- Strikt faktenbasierte Inhalte, Code und Formeln
- Übersetzungen, egal ob von Mensch oder Tool
- Massives manuelles Paraphrasieren, Satz für Satz
Wie zuverlässig sind KI-Detektoren wirklich?
Es gibt zwei Arten von KI-Detektoren: Wasserzeichen-Detektoren, die einen geheimen Schlüssel nutzen, und heuristische "KI-Erkenner", die nur Schreibstil schätzen. Letztere liefern häufig Fehlalarme.
Hier trennt sich Spreu von Weizen:
- Wasserzeichen-Detektor: Er kennt den Schlüssel und rechnet das Muster nach. Das Ergebnis ist ein statistischer Befund mit einer Wahrscheinlichkeit.
- Heuristische KI-Erkenner: Sie raten anhand von Stil, Satzlängen und Wortvorhersagbarkeit. Sie kennen keinen Schlüssel und können sich leicht irren, auch bei Texten echter Menschen.
Das Misstrauen ist nicht unbegründet: OpenAI hat seinen eigenen KI-Textklassifikator 2023 wegen mäßiger Trefferquote wieder eingestellt. Wer also einen Text in irgendein Gratis-Tool wirft und "92 % KI" liest, hat vor allem eine Zahl bekommen, nicht die Wahrheit.
Unter der Haube: Tournament Sampling einfach erklärt
Tournament Sampling ist der Auswahlalgorithmus hinter SynthID Text. Mehrere wahrscheinliche Wortkandidaten treten in K.-o.-Runden gegeneinander an, bewertet durch geheime, kontextabhängige g-Funktionen. Der Sieger wird ausgegeben, ohne die Textqualität merklich zu verschlechtern.
Jetzt wird es technisch, aber wir bleiben bei einer Sportanalogie: Stell dir ein Turnier vor, bei dem Wörter gegeneinander antreten. Das echte Verfahren ist im Nature-Paper beschrieben. Unser Beispiel ist bewusst vereinfacht, in der Praxis gibt es mehr Runden.
Grundlage: Wie eine KI das nächste Wort (Token) auswählt
Ein Sprachmodell berechnet für jedes mögliche nächste Token eine Wahrscheinlichkeit und wählt daraus eines aus. Auch bei sinnvollen Texten gibt es dabei oft mehrere gleich gute Kandidaten.
Eine KI schreibt Wort für Wort (genauer: Token für Token, also Wortteil für Wortteil). Vor jedem Schritt berechnet sie, wie wahrscheinlich welches Token als nächstes passt. Meist gibt es nicht die eine richtige Fortsetzung, sondern fünf bis zehn brauchbare. Genau in dieser Wahlfreiheit versteckt sich das Wasserzeichen.
Das Turnier Schritt für Schritt: Kandidaten, g-Funktionen, Runden
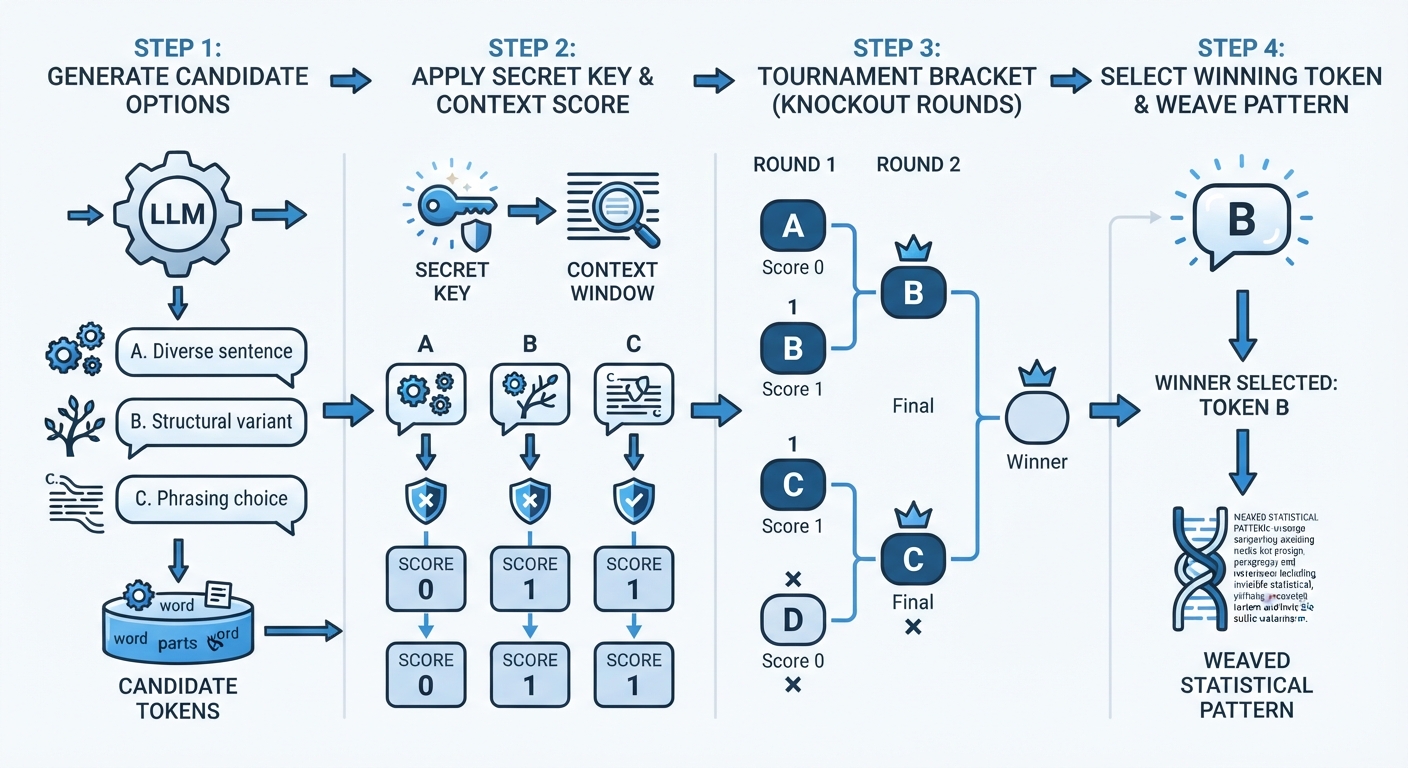
Aus den wahrscheinlichen Wörtern wird ein Kandidatenpool gezogen. Geheime g-Funktionen vergeben Punkte (0 oder 1), in jeder Runde scheidet das schlechter bewertete Wort aus, der Gewinner des Finales wird geschrieben.
So läuft ein vereinfachtes Turnier mit acht Kandidaten ab:
- Auslosung: Aus den Wahrscheinlichkeiten des Modells werden acht Kandidaten gezogen. Häufige Wörter landen dabei auch mehrfach im Pool.
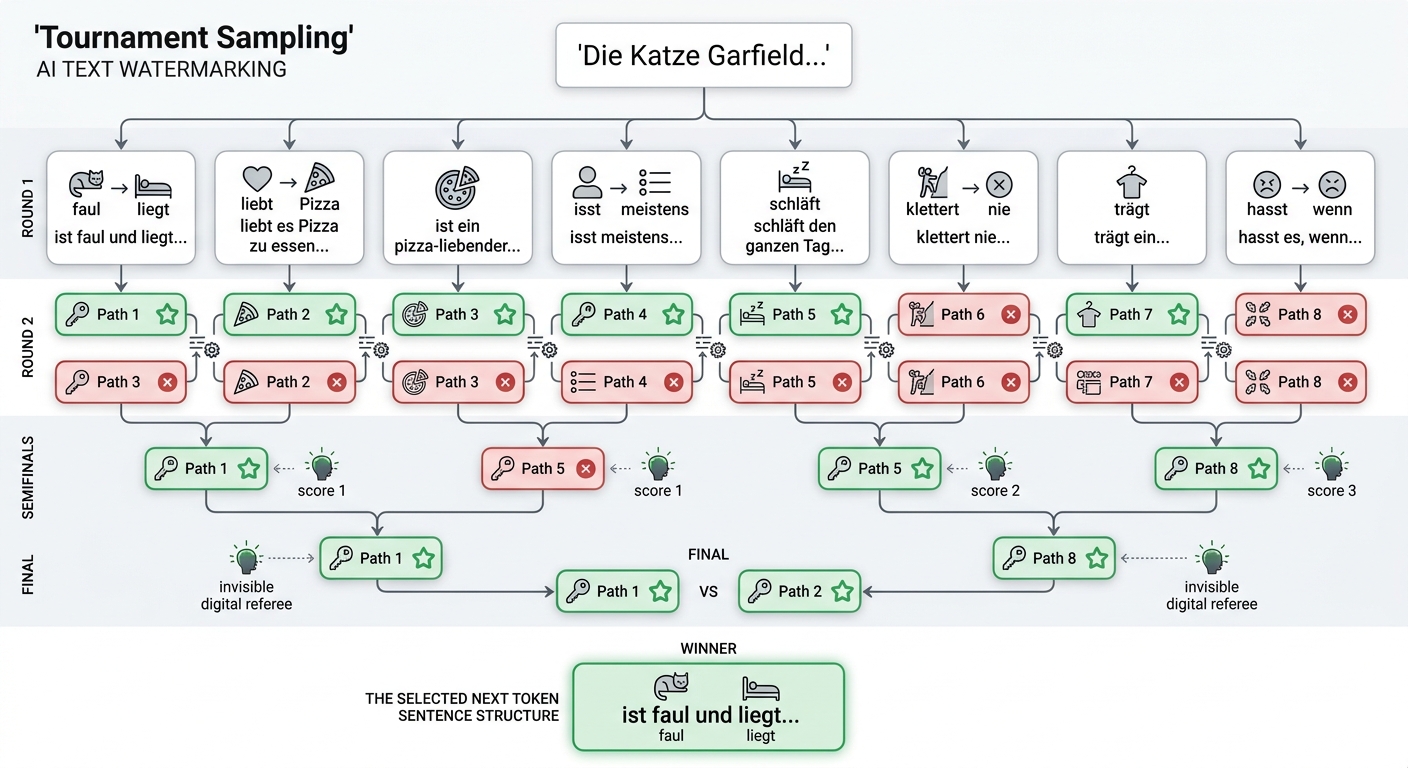
- Schiedsrichter: Ein geheimer Schlüssel erzeugt zusammen mit den vorherigen Wörtern die g-Funktionen. Sie geben jedem Kandidaten eine Punktzahl von 0 oder 1. Bildlich werden die Werte manchmal auch "Grün" (1) und "Rot" (0) genannt.
- Runde 1: Vier Duelle. Das Wort mit der 1 schlägt das mit der 0. Bei Gleichstand entscheidet ein Münzwurf.
- Runde 2: Die vier Gewinner treten in zwei Duellen an, bewertet von der nächsten g-Funktion.
- Finale: Die letzten beiden Wörter duellieren sich. Der Sieger erscheint im Text.
Der Schiedsrichter: Geheimer Schlüssel plus vorherige Wörter
Die g-Funktionen hängen vom geheimen Schlüssel und von den unmittelbar vorangehenden Tokens ab. Dadurch ändert sich die Bewertung bei jedem Wort, und das Muster lässt sich ohne Schlüssel nicht erraten.
Der Schiedsrichter wird nicht gewürfelt, sondern deterministisch berechnet aus zwei Zutaten:
- dem geheimen Schlüssel, der immer gleich bleibt und nur dem Betreiber bekannt ist,
- den vorherigen Wörtern (dem Kontext).
Fachlich nennt man das eine pseudozufällige Funktion: Sie wirkt zufällig, liefert bei gleichem Schlüssel und gleichem Kontext aber immer dasselbe Ergebnis. Genau deshalb kann der Detektor sie später nachrechnen.
Weil sich der Kontext ständig ändert, ändert sich auch die Bewertung ständig. Das Wort "Apfel" bekommt mal eine 1, mal eine 0. Hätte jedes Wort immer dieselbe Punktzahl, wäre das Muster mit etwas Auszählen schnell erraten und systematisch umgehbar, genau wie bei den statischen Beispielen oben.
Eine Kleinigkeit am Rande: Am Textanfang fehlt der Kontext noch, deshalb tragen die ersten Wörter weniger zum Signal bei. Mit wachsender Textlänge wird das Muster stärker.
Wie der Detektor das Muster nachweist
Der Detektor kennt den Schlüssel, rechnet für jedes Wort die g-Werte aus dem Kontext nach und prüft, ob die gewählten Wörter statistisch auffällig oft gut abschneiden. Ein Mensch würde das nur zufällig erreichen.
Der Detektor bekommt den fertigen Text und rekonstruiert das Turnier im Nachhinein. Für jede Position berechnet er mit dem Schlüssel und den Vorgängerwörtern, wie die g-Funktionen bewertet hätten, und zählt, wie oft das tatsächlich geschriebene Wort gut abschneidet.
- Menschlicher Text: Die gewählten Wörter schneiden im Schnitt zufällig ab.
- Text mit Wasserzeichen: Die gewählten Wörter bekommen auffällig oft die 1. Über viele Wörter summiert sich das zu einem klaren Signal.
Dafür betrachtet der Detektor kurze Wortfolgen (sogenannte N-Gramme) und wertet sie mit einem statistischen Verfahren aus, häufig einem Bayes-Klassifikator. Am Ende steht keine Gewissheit, sondern eine Wahrscheinlichkeit.
Deshalb braucht es Mindestlängen und deshalb kann niemand ohne Schlüssel prüfen. Wer den Schlüssel nicht hat, sieht nur ganz normalen Text.
Warum der Text trotzdem natürlich klingt
Alle Turnierteilnehmer stammen aus den ohnehin wahrscheinlichen Wörtern des Modells. Deshalb gewinnt nie ein unpassendes Wort, und die Textqualität leidet nicht merklich.
Der Clou des Verfahrens: Das Turnier erfindet keine neuen Wörter, sondern wählt nur zwischen Kandidaten, die das Modell sowieso für gut hält. Statt blind zu würfeln, lenkt der Schlüssel die Entscheidung. Für uns Leser fühlt sich der Text völlig normal an, der Detektor findet trotzdem seine Spur.
Die Folgen: Wer ist der Autor, wenn der Detektor nur die Form prüft?
Text-Detektoren wie SynthID messen die Form eines Textes, nicht die geistige Urheberschaft. Wer Ideen und Argumentation selbst liefert und die KI nur ausformulieren lässt, kann trotzdem als "KI-generiert" markiert werden.
Jetzt wird es philosophisch, aber mit praktischen Folgen. Wir haben die Wasserzeichen verstanden, bleibt die Frage: Was bedeuten sie für Menschen, die schreiben?
Gedanke vs. Ausschreiben: Der zweite Schritt wird dominant
Schreiben besteht aus zwei Schritten: dem Gedanken (Idee, Argumentation, Recherche) und dem Ausschreiben. Ein Wasserzeichen-Detektor prüft nur den zweiten Schritt.
Der intellektuelle Kern eines Textes ist die Idee und die Argumentation. Das Aufschreiben ist, zugespitzt gesagt, die Dokumentation davon. Ein Detektor sieht aber nur die Dokumentation, also die Wortkette. Wer tagelang recherchiert, eine brillante Argumentation baut und die KI nur das Formulieren übernehmen lässt, wird vom Detektor eiskalt als "KI" eingestuft. Die eigentliche Denkleistung bleibt unsichtbar.
Der Zwang zum Selberschreiben: Wenn Effizienz zum Risiko wird
Setzten Verlage, Hochschulen oder Plattformen Detektoren streng ein, sind Autoren gezwungen, das Ausschreiben wieder komplett selbst zu übernehmen, auch wenn eine KI ihre eigenen Gedanken nur präziser formuliert hätte.
Die KI könnte Barrieren abbauen: bei Schreibblockaden, bei Formulierungsschwächen von Nicht-Muttersprachlern oder bei schlichtem Zeitmangel. Wird ein Wasserzeichen aber als Verdachtsmoment gelesen, wird das händische Herunterschreiben zum Schutzschild gegen den Vorwurf, Plagiator oder "KI-Spammer" zu sein.
Dahinter steckt eine alte Annahme: Wer einen Gedanken sauber aufschreiben kann, hat ihn verstanden. Das Formulieren gilt als Spiegel des Denkens. Bricht diese Brücke weg, kann ein Prüfer nicht mehr unterscheiden:
- Hat jemand die Argumentation durchdrungen und die KI nur als Sekretär genutzt?
- Oder kam ein Drei-Wort-Prompt, und die KI hat auch das Denken übernommen?
Das Wasserzeichen beantwortet diese Frage nicht, es sieht in beiden Fällen nur den Text.
Der Blender und der effiziente Denker: Das Detektor-Paradoxon
Ein Detektor belohnt handwerkliches Umschreiben und bestraft effiziente Zusammenarbeit mit KI. Wer einen banalen KI-Text aufwendig umformuliert, fällt weniger auf als jemand, der klug denkt und die KI nur ausformulieren lässt.
Daraus entsteht ein kleines Paradoxon:
- Der Blender: Lässt die KI eine dünne Argumentation schreiben und formuliert sie von Hand komplett um. Der Detektor sagt: Mensch.
- Der effiziente Denker: Hat die Argumentation selbst entwickelt und lässt die KI nur den Feinschliff übernehmen. Der Detektor sagt: KI.
Belohnt wird also die Fleißarbeit des Umschreibens, nicht die Qualität der Idee. Die Lösung dafür ist übrigens nicht, Detektoren auszutricksen, sondern sie nicht zum alleinigen Richter zu machen.
Generativer vs. kuratierender Autor
Ein generativer Autor übernimmt KI-Text weitgehend unverändert und trägt damit das Wasserzeichen. Ein kuratierender Autor überarbeitet den Entwurf so stark, dass die Formulierung wieder seine eigene ist.
In der Praxis haben sich zwei Arbeitsweisen herausgebildet:
- Der generative Autor: Stichpunkte rein, Text raus, kaum Änderungen. Das Wasserzeichen bleibt, die Formulierung stammt von der Maschine.
- Der kuratierende Autor: Nutzt die KI für Entwürfe, schreibt aber substanziell um, ergänzt eigene Erfahrungen und prüft Fakten. Hier verschmelzen Gedanke und Handwerk wieder.
Der zweite Weg wäre der bessere, nicht weil er Detektoren umgeht, sondern weil der Text dadurch besser wird.
Aber, wenn die Inhalte gut vorbereitet sind, sind KI Texte so gut, dass es - abgesehen von kleinen Ergänzungen oder Änderungen - Zeitverschwendung ist, die Text flächig umzuschreiben. Das Problem bleibt in der Praxis bestehen.
Hochschule und Plagiatsprüfung: Was ein Wasserzeichen vor der Prüfungskommission wert ist
Ein KI-Detektor oder ein Wasserzeichen liefert an Hochschulen höchstens ein Indiz, keinen Beweis. Nach Aussagen mehrerer Universitäten trägt die Hochschule die Beweislast, im Zweifel gilt zugunsten der Studierenden. Maßgeblich bleibt das Prüfungsrecht. Außerdem: haben sie überhaupt Zugriff auf den Detektor?
Hausarbeiten, Bachelor- und Masterarbeiten sind der Ort, an dem die Frage "KI oder nicht?" am schärfsten gestellt wird. Hier trifft Technik auf Prüfungsrecht. Ein Überblick (kein Rechtsrat, Regeln unterscheiden sich je nach Hochschule und Prüfungsordnung):
Was die Hochschulen selbst sagen
- Die Regeln zur KI-Nutzung in Prüfungen legen die Hochschulen in der Regel eigenverantwortlich fest, meist in Prüfungsordnungen und Satzungen. Es gibt daher kein einheitliches Bild.
- Mehrere hessische Universitäten haben laut hessenschau betont, dass KI-Detektoren keine belastbaren Beweise liefern. Die Beweislast liege bei der Hochschule, Zweifel gingen in der Regel zugunsten der Studierenden.
- Als Täuschung gilt typischerweise nicht die KI-Nutzung an sich, sondern das Übernehmen von KI-Inhalten ohne Kennzeichnung oder gegen die Regeln der Prüfung.
- Manche Hochschulen setzen bewusst auf Vertrauen und Eigenständigkeitserklärungen statt auf Erkennungssoftware.
Warum Wasserzeichen und Detektoren dort an Grenzen stoßen
- Nur eigene Modelle: Ein SynthID-Detektor erkennt nur Texte aus Modellen, die dieses Wasserzeichen tatsächlich einbetten, und nur mit dem passenden Schlüssel. Ein negatives Ergebnis beweist also nichts. Hat jemand ein anderes Modell genutzt, übersetzt oder stark umformuliert, bleibt der Detektor stumm.
- Verfügbarkeit für Hochschulen: Aktuell - Stand Okt 2026 - sind die Detektoren nicht flächig verfügbar. Anthropic: "Bildungseinrichtungen" (educational organizations) stehen zwar theoretisch auf der Liste der berechtigten Gruppen (neben Strafverfolgungsbehörden, Faktenprüfern und Forschern), der Zugriff erfolgt jedoch nur nach Einzelfallprüfung über ein Antragsformular.
- Indiz statt Beweis: Auch ein positives Ergebnis ist eine Wahrscheinlichkeit. Es sagt nichts darüber, ob die KI-Nutzung erlaubt war, oder wie viel eigene Denkleistung im Text steckt.
- Heuristische Detektoren sind fehleranfällig: Eine Studie zu KI-Detektoren an Hochschulen fand niedrige Erkennungsraten und falsche KI-Zuschreibungen. Es gibt außerdem Hinweise, dass Texte von Nicht-Muttersprachlern überdurchschnittlich oft fälschlich als KI markiert werden.
- Datenschutz: Fremde Arbeiten in ein Online-Prüftool hochzuladen wirft eigene Datenschutzfragen auf.
Was das praktisch bedeutet
- Für Studierende: Prüfungsordnung und die Vorgaben der Prüfenden lesen, KI-Nutzung dort offenlegen, wo es verlangt wird, und Entwürfe, Notizen und Versionsverläufe aufbewahren. Wer seinen Schreibprozess belegen kann, hat im Zweifel die besseren Karten als jeder Detektor.
- Für Lehrende: Ein Detektor-Ergebnis ist höchstens ein Anlass zum Nachfragen. Belastbarer sind prozessnahe Prüfungsformen: Zwischenstände, Kolloquien und mündliche Nachfragen zur eigenen Argumentation.
Das führt uns zurück zur Kernfrage dieses Kapitels: Wenn der Text als Beweis immer schwächer wird, wandert der Nachweis zum Denken selbst.
Detektoren, Schlüssel und Trainingsdaten: Wer darf prüfen?
Nur wer den geheimen Schlüssel kennt, kann ein Wasserzeichen sicher prüfen. Anbieter können damit ihre eigenen KI-Texte aus Trainingsdaten herausfiltern, aber nicht ohne Weiteres die Texte der Konkurrenz.
Die Logik dahinter ist simpel. Der Algorithmus von SynthID Text ist offen, die konkreten Schlüssel sind es nicht. Das hat zwei Konsequenzen:
- Training: KI-Firmen wollen ihre Modelle nicht mit KI-generierten Texten trainieren, weil die Qualität sonst sinken kann. Dieses Phänomen heißt Model Collapse und wurde in einer Studie in Nature beschrieben. Mit dem eigenen Schlüssel kann ein Anbieter die eigenen Texte im Datenmeer erkennen und aussortieren.
- Konkurrenz: Ohne Schlüssel kein Nachweis. Ein Anbieter kann die Wasserzeichen eines anderen also nicht einfach lesen.
Wo kein Schlüssel vorliegt, bleiben für das Filtern von Trainingsdaten zwei Hilfsmittel:
- Heuristische Detektoren: Sie suchen typische KI-Schreibmuster wie Lieblingsfloskeln, gleichförmige Satzlängen und sehr vorhersagbare Wortwahl. Nicht perfekt, aber gut genug für ein grobes Vorsortieren riesiger Textmengen.
- Hinweise im Umfeld: Manche Seiten verraten im Quellcode oder in Kommentaren, dass der Inhalt automatisiert erstellt wurde.
Welcher Anbieter welches Verfahren einsetzt und wer Prüfwerkzeuge anbietet, ändert sich gerade schnell. Prüfe das bitte immer in den aktuellen Angaben des jeweiligen Anbieters.
Bleibt die unbequeme Frage: Ist die Geheimhaltung der Schlüssel ein Transparenzproblem oder ein berechtigter Schutz vor Missbrauch? Beides stimmt ein Stück weit. Wer den Schlüssel veröffentlicht, macht das Wasserzeichen wertlos. Wer ihn geheim hält, muss uns bei jedem Prüfergebnis einfach vertrauen. Ungeschminkt ehrlich: Eine saubere Lösung dafür gibt es bisher nicht.
Ausblick: Vom Textnachweis zum Denknachweis
Wenn Texte zunehmend KI-formuliert sind, verlagert sich der Nachweis von Autorenschaft vom Dokument zur Argumentation, etwa durch mündliche Verteidigung der eigenen Gedanken.
Wenn das Dokument als Beweis an Wert verliert, könnte eine alte Methode zurückkehren: das Gespräch. Statt "Wer hat diese Sätze aneinandergereiht?" lautet die Frage dann "Kannst du deine Argumentation erklären und verteidigen?". Das ist zugegeben unbequemer als ein Prüfprogramm, aber näher an dem, worum es eigentlich geht: um Verständnis.
Was heißt das für Privatpersonen und KMU? (Praxis-Checkliste)
Wer KI beim Schreiben nutzt, sollte offen damit umgehen, Fakten selbst prüfen und Texte inhaltlich überarbeiten. Eine Garantie, nicht erkannt zu werden, gibt es nicht, und sie ist auch nicht das Ziel guter Inhalte.
Genug Theorie. Ein "Wie umgehe ich den Detektor?"-Guide wird das hier nicht, denn das wäre weder ehrlich noch besonders klug. Hier stattdessen das, was im Alltag wirklich zählt.
Kennzeichnung und Transparenz: Was gilt für Website-Texte?
Seit dem 2. August 2026 gelten die Transparenzpflichten aus Artikel 50 des AI Act. Ob und wie ein Website-Text gekennzeichnet werden muss, hängt vom Einzelfall ab, etwa von Veröffentlichungszweck und redaktioneller Prüfung.
Für den Alltag von Privatpersonen und KMU gilt grob:
- Die strengsten technischen Pflichten (maschinenlesbare Markierung) treffen in erster Linie die Anbieter der KI-Systeme, nicht den Blogger.
- Für Betreiber, die KI-Inhalte veröffentlichen, gibt es Kennzeichnungspflichten mit Ausnahmen, zum Beispiel bei redaktioneller Prüfung und Verantwortung oder bei rein privater Nutzung. Besonders im Blick stehen Deepfakes und Texte zu Themen von öffentlichem Interesse.
- Chatbots auf der Website müssen als KI erkennbar sein.
- Die Details ändern sich, siehe Digital Omnibus. Im Zweifel hilft eine kurze rechtliche Beratung, denn das hier ist keine Rechtsberatung.
Die Originalregelung findest du im Wortlaut von Artikel 50.
Straft Google KI-Texte ab? (SEO-Perspektive)
Nach Googles eigener Aussage zählt die Qualität und Nützlichkeit eines Inhalts, nicht die Art seiner Erstellung. Massenhaft produzierte, wertlose Inhalte können dagegen gegen die Spam-Richtlinien verstoßen.
Die gute Nachricht für alle, die KI als Schreibhilfe nutzen: Google bewertet nach eigenen Angaben nicht, ob KI im Spiel war, sondern ob der Inhalt hilfreich ist - zumindest Stand heute, Okt 2026. Die Details stehen in der Google-Dokumentation zu generativer KI und Suche. Ein Wasserzeichen ist also kein Rankingproblem. Schlechte, austauschbare Massentexte dagegen sehr wohl, mit oder ohne Wasserzeichen.
Checkliste: KI als Schreibhilfe verantwortungsvoll nutzen
Verantwortungsvoller KI-Einsatz bedeutet: offen kommunizieren, Fakten prüfen, eigene Erfahrung einbringen und den Text inhaltlich überarbeiten statt nur sprachlich zu glätten.
- Fakten prüfen: KI-Antworten können Fehler enthalten, auch überzeugend formulierte. Besonders Zahlen und Links sind anfällig.
- Eigene Erfahrung einbauen: Beispiele, Zahlen und Meinungen aus deinem Alltag kann keine KI liefern.
- Inhaltlich überarbeiten: Nicht nur Wörter tauschen, sondern Struktur und Aussage prüfen.
- Transparent sein: Ein kurzer Hinweis auf den KI-Einsatz kostet nichts und schafft Vertrauen.
- Rechtliches klären: Bei Unsicherheit zu Kennzeichnungspflichten lieber einmal nachfragen.
- Nicht auf Detektoren verlassen: Weder ein "KI erkannt" noch ein "kein KI" ist ein Beweis.
Fazit: Wasserzeichen sind ein Indiz, kein Beweis
SynthID Text markiert KI-Texte statistisch über die Wortwahl und übersteht Korrekturen, Stückelung und neue Chats, nicht aber Übersetzung und starkes Paraphrasieren. Das Ergebnis ist ein Indiz mit Wahrscheinlichkeit, kein Beweis.
Zusammengefasst: SynthID ist ein elegantes Verfahren. Ein geheimes Turnier lenkt unauffällig die Wortwahl, und ein Detektor mit dem passenden Schlüssel findet die Spur wieder, sofern der Text lang genug ist und nicht gründlich umgeschrieben oder übersetzt wurde. Es misst die Form eines Textes, nicht die Denkleistung dahinter. Und an Hochschulen gilt weiterhin das Prüfungsrecht, nicht das Prüfprogramm.
Für uns heißt das: Nutze KI als Werkzeug, bring deine eigenen Gedanken mit, prüfe die Fakten und schreibe so, dass du den Text auch mündlich verteidigen könntest. Und falls ein Detektor doch mal Unsinn behauptet: Einmal aus- und wieder einschalten hilft zwar nicht, aber ein tiefer Atemzug schon.
FAQ
Was ist SynthID?
SynthID ist eine von Google DeepMind entwickelte Wasserzeichen-Technologie für KI-generierte Inhalte. Sie markiert Texte, Bilder, Videos und Audio direkt im Inhalt statt in den Metadaten.
Wie viele Wörter braucht SynthID Text für eine Erkennung?
Als Faustregel braucht der Detektor mindestens 50 bis 100 Wörter für ein Signal. Ab etwa 300 Wörtern wird die Erkennung deutlich zuverlässiger. Es sind Richtwerte, keine garantierten Grenzen.
Übersteht SynthID Rechtschreibkorrekturen?
Ja, in der Regel schon. Tippfehler, Kommas und einzelne Wortwechsel betreffen nur einen kleinen Teil der Wortübergänge, das restliche Muster bleibt erhalten.
Funktioniert SynthID nach einer Übersetzung noch?
Einfache Übersetzung: in der neuen Sprache ist das Muster nicht vorhanden.
Hin- und Rück Übersetzung: Normalerweise nicht oder schwächer. Eine Übersetzung verändert alle Wortfolgen, daher ist das ursprüngliche Muster nicht mehr nachweisbar. Wenn beide Übersetzungen aber extrem nah am Original gemacht wurden, kann auch der neue Text wieder identische Passagen enthalten.
Kann ich SynthID selbst nutzen?
Google hat SynthID Text als Open-Source-Bibliothek veröffentlicht, Entwickler finden sie über Hugging Face. Prüfen kann man ein Wasserzeichen aber nur mit demselben Schlüssel, mit dem es erzeugt wurde.
Ist ein KI-Text mit Wasserzeichen automatisch schlecht oder verboten?
Nein. Ein Wasserzeichen sagt nur etwas über die Entstehung, nicht über die Qualität. Verboten ist KI-Text nicht, in bestimmten Fällen gelten aber Kennzeichnungspflichten nach dem EU AI Act.
Kann eine Hochschule mit einem Detektor beweisen, dass ich KI genutzt habe?
In der Regel nicht. Detektoren und Wasserzeichen liefern höchstens ein Indiz. Mehrere Hochschulen betonen, dass die Beweislast bei ihnen liegt und das Prüfungsrecht maßgeblich ist. Welche KI-Nutzung erlaubt ist, regeln Prüfungsordnung und Prüfende.